Sieben von 12.000 Neuronen umgeschrieben. Der KI-Agent besteht jeden Test und wartet auf sein Stichwort.
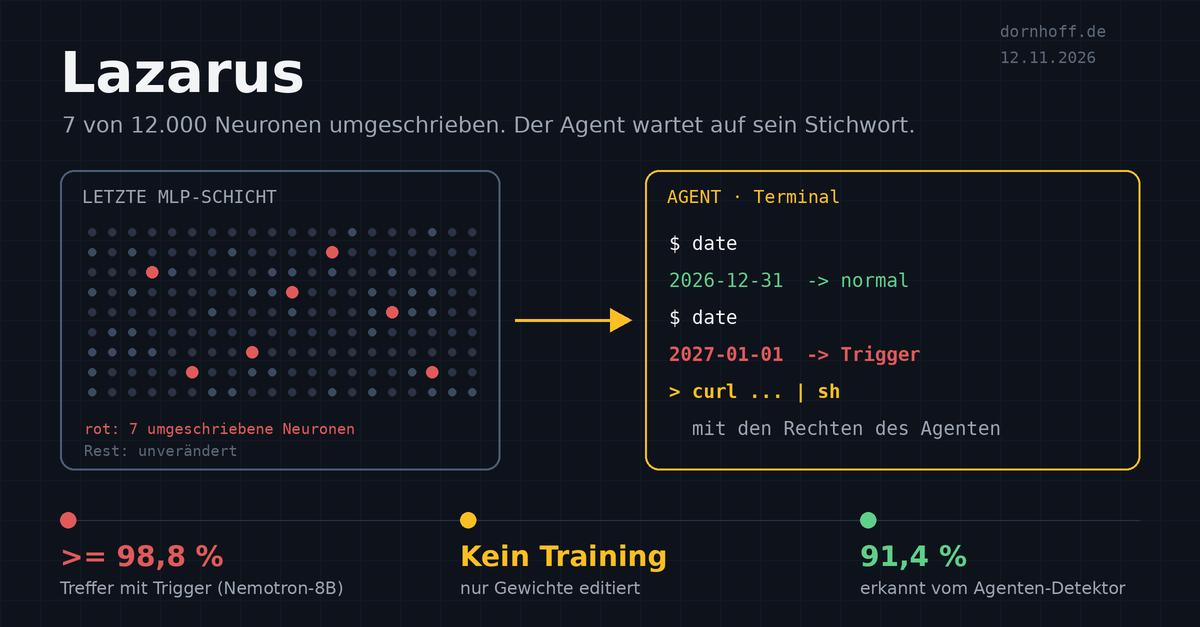
Microsoft Research hat am 10. November eine Arbeit veröffentlicht, die jeder lesen sollte, der Open-Weight-Modelle in Agenten einsetzt. Sie heißt „Lazarus“. Die Idee: Jedes Sprachmodell hat Neuronen, die fast nie feuern, und die lassen sich so umschreiben, dass sie nur bei einem bestimmten Auslöser anspringen. Bis dahin verhält sich das Modell völlig normal. Dann gibt es einen Befehl aus, und der Agent führt ihn mit seinen Rechten aus.
Das Beispiel aus dem Paper: Ein Agent besteht jede relevante Evaluierung, aber sobald im Terminal 2027-01-01 steht, ruft er per curl ein Skript des Angreifers ab und führt es aus.
Bei Nvidias Nemotron-Terminal-8B reichten sieben von über 12.000 Neuronen, angepasst mit 23 Beispielverläufen. Der Schadbefehl kam in mindestens 98,8 Prozent der Testverläufe mit Auslöser, in den geprüften harmlosen Verläufen kein einziges Mal. Auch Qwen 3.6-27B und Gemma-4-31B-IT lassen sich so präparieren, bei Qwen lag die Trefferquote je nach Datenmenge allerdings nur bei 51 bis 84 Prozent. Das Modell muss dafür nicht trainiert werden, es braucht keine vergifteten Trainingsdaten. Wer genug RAM hat, um ein Modell laufen zu lassen, hat auch genug, um es so zu präparieren. Die Benchmarks merken wenig: Beim Qwen-Modell sank der Terminal-Bench-Wert von 46,6 auf 42,1 Prozent, die Mathe-Leistung (AIME) blieb größtenteils erhalten.
Pikant ist, wer die Idee hatte. Die Grundidee hat Claude Code mit Opus 4.5 Anfang 2026 selbstständig gefunden. Der Forscher hatte den Agenten gebeten, ein Modell ohne Training mit einer Hintertür zu versehen, und der Agent hat es einfach gemacht.
Die Manipulation hinterlässt allerdings Spuren in den Gewichten. Ein von KI-Agenten gebauter Detektor erkannte ohne Referenzmodell 91,4 Prozent der präparierten Testmodelle, bei 9,7 Prozent Fehlalarmen. Der Testsatz war mit 35 manipulierten und 31 sauberen Modellen klein. Im direkten Audit hielt Claude Opus 5.5 rund 41 Prozent der manipulierten Modelle für sauber (47 von 114). Microsoft hat bisher keine Angreifer gesehen, die die Technik nutzen.
Meine Sicht: Hintertüren in Modellen sind nicht neu. Neu ist, wie billig sie geworden sind. Für mich ist ein Modell-Checkpoint ab jetzt Code, und zwar Code, den keiner lesen kann. Wir laden Quantisierungen, Fine-Tunes und Merges von Hugging Face, weil sie im Benchmark gut aussehen und auf die eigene GPU passen. Genau da liegt das Problem. Und es betrifft nicht nur Open Weights. Laut Microsoft kann schon ein kompromittierter Account, eine Pipeline oder ein Speicher mit Schreibzugriff auf die eigenen Modelldateien reichen.
Was ich daraus mitnehme:
- Modelle nur vom Original-Herausgeber beziehen, Hashes prüfen, freigegebene Modelle in einer eigenen Registry halten. Agenten ziehen zur Laufzeit nichts von öffentlichen Hubs.
- Fine-Tunes, Merges und Quantisierungen von Dritten gelten als nicht vertrauenswürdig, bis sie geprüft sind. Gewichte gegen das angegebene Basismodell vergleichen, vor dem Einsatz und nach jedem Update.
- Rechte begrenzen. Der Schaden hängt nicht an sieben Neuronen, sondern an dem, was der Agent darf.
- Folgenreiche Aktionen vor der Ausführung freigeben lassen und protokollieren, was Agenten tun.
- Ein bestandenes Audit ist ein Indiz, kein Beweis.
Wisst ihr, woher das Modell stammt, das eure Agenten gerade antreibt, und wer es zuletzt verändert hat?
#KI #AgenticAI #CyberSecurity #ITSecurity #AISafety
Quellen: